简介
DeepAgents 是 LangChain 官方维护的一个独立 Python 开源项目,它被称为一个 agent harness,官方定位是:
“Deep Agents is the easiest way to start building agents and applications that are powered by LLMs — with built-in capabilities for file systems for context management, subagent-spawning, and long-term memory.”
“It is the same core tool calling loop as other agent frameworks, but with built-in capabilities that make agents reliable for real tasks.”
也就是说,DeepAgents 不是重新发明了一套 Agent 循环,而是在标准的”模型决策 → 调用工具 → 读取结果 → 继续决策”这个循环之外,把权限控制、审批、子任务委派、长会话记忆这些几乎每个生产级 Agent 都要重新造一遍的基础设施内置了。
官方 harness 能力
官方文档用一张图把 DeepAgents 的能力分成四类,这是理解这个包最直接的方式:
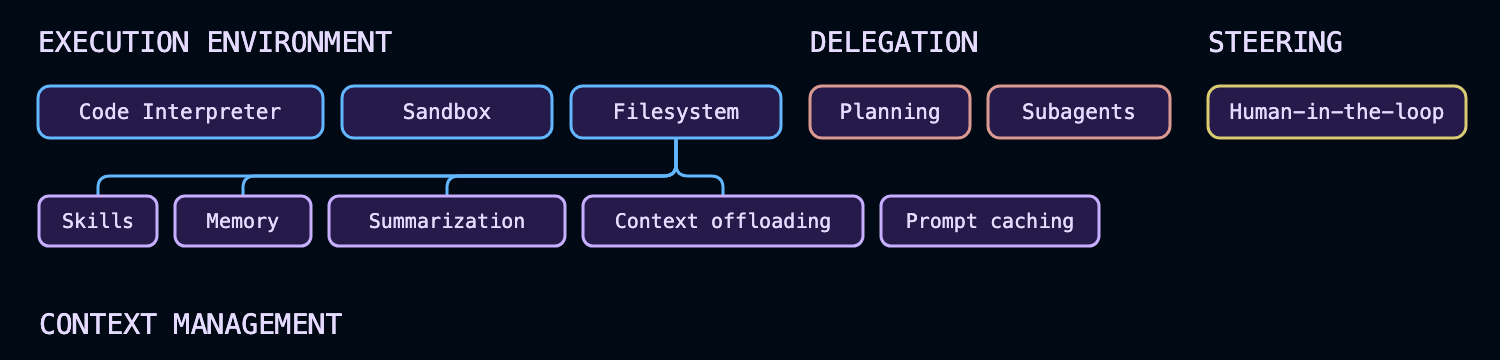
Execution Environment
解决 agent 在哪里、怎么执行动作:通过虚拟文件系统、声明式权限规则和可选的沙箱/代码执行层,让 agent 能读写文件、跑代码,同时把这些操作限制在安全边界内。
| 能力 | 说明 |
|---|---|
| Tools and MCP | 自定义函数、LangChain 工具、MCP 服务器都可以接入 |
| Filesystem | 一个”可插拔后端的虚拟文件系统”,内置 ls、read_file、write_file、edit_file、glob、grep 工具 |
| Filesystem Permissions | 声明式规则,控制 agent 能读写哪些路径 |
| Sandbox / Code Interpreter | Sandbox 后端支持跑 shell 命令和装依赖;Interpreter 是更轻量的代码执行层(基于 QuickJS 运行时) |
Context Management
解决长任务如何不撑爆上下文窗口,这组能力挂在 Filesystem 之下:按需加载知识、跨会话记忆、自动摘要,把不必要的内容挪出主对话或直接缓存,控制真正进入模型上下文的内容量。
| 能力 | 说明 |
|---|---|
| Skills | 按需加载的领域知识,遵循 Agent Skills 标准,从 SKILL.md 文件读取,官方叫这个机制 “progressive disclosure” |
| Memory | 通过 agents.md 文件跨会话持久化指令和偏好 |
| Summarization | 压缩会话历史,避免长任务超出 token 限制 |
| Context offloading | 把大型工具结果挪出主对话,只在需要时再取回 |
| Prompt caching | Anthropic / Amazon Bedrock 模型上自动生效,缓存系统提示中不变的部分 |
Memory 这一行 agents.md 的具体机制见后面「记忆」一节。
Delegation
解决复杂任务如何拆解执行:用一份可选的任务列表跟踪进度,把子任务交给一次性的、上下文隔离的子 agent 并行处理,只拿回一份最终报告。
| 能力 | 说明 |
|---|---|
| Planning | 可选的 write_todos 工具,维护一个带 pending/in_progress/completed 状态的任务列表 |
| Subagents | 官方原话是 “ephemeral child agents that handle isolated subtasks” —— 一次性的、隔离上下文的子任务执行者,只返回一份最终报告给主 agent |
Steering
解决人如何介入 agent 的执行过程:基于 LangGraph 的中断机制,在敏感操作真正执行前暂停,等待审批后再继续。
| 能力 | 说明 |
|---|---|
| Human-in-the-loop | 基于 LangGraph 的 interrupt 机制,通过 interrupt_on 参数在敏感工具调用前暂停执行等待审批 |
这四类能力全部通过给 create_deep_agent() 传参数来开启,不需要自己实现底层机制。下面每一节都会用实测跑通的代码演示其中几个核心能力。
快速上手
以下代码在真实环境中跑通过(模型用任意 OpenAI 兼容服务,示例用 DeepSeek),完整版本见项目里的 features/01_basic_agent.py。
import os
from dotenv import load_dotenv
from langchain.tools import tool
from langchain_openai import ChatOpenAI
from deepagents import create_deep_agent

load_dotenv()

@tool
def add_numbers(a: int, b: int) -> int:
    """Add two numbers"""
    return a + b

llm = ChatOpenAI(
    model=os.getenv("LLM_MODEL"),
    api_key=os.getenv("LLM_API_KEY"),
    base_url=os.getenv("LLM_API_BASE_URL"),
)

agent = create_deep_agent(
    model=llm,
    tools=[add_numbers],
    system_prompt="You are a math assistant. Use tools to solve problems.",
)

result = agent.invoke({"messages": [{"role": "user", "content": "Calculate 5 + 3"}]})
print(result["messages"][-1].content)
有个容易忽略的细节:create_deep_agent 默认自带一批工具(ls、read_file、write_file、edit_file、
glob、grep、execute、task),tools 参数传入的是在这些默认工具之上追加的自定义工具,不是替换。
如果不需要 agent 自己探索一个不存在的虚拟文件系统,最好在 system_prompt 里明确告诉它任务范围,
否则模型有时会先尝试用默认工具查看环境,得到空结果后才继续。
harness 能力
人机协同
DeepAgents 的人机协同不是自己写一个等待循环,而是 create_deep_agent 的 interrupt_on 参数,
内部会自动挂载 LangChain 的 HumanInTheLoopMiddleware。完整流程如下:
from langgraph.checkpoint.memory import InMemorySaver
from langgraph.types import Command
from deepagents import create_deep_agent

agent = create_deep_agent(
    model=llm,
    tools=[delete_logs],
    interrupt_on={"delete_logs": {"allowed_decisions": ["approve", "reject"]}},
    checkpointer=InMemorySaver(),  # 暂停和恢复都要靠 checkpointer 保存图状态
)

config = {"configurable": {"thread_id": "demo-1"}}
result = agent.invoke({"messages": [{"role": "user", "content": "free up disk space"}]}, config=config)

if "__interrupt__" in result:
    # 把 result["__interrupt__"][0].value 转发给审批方, 拿到决定后恢复执行
    result = agent.invoke(Command(resume={"decisions": [{"type": "approve"}]}), config=config)
整个流程画成图更清楚,LangGraph 具体负责哪一段一目了然:
[LLM]           决定调用被 interrupt_on 保护的工具(比如 delete_logs)
   |
   v
[LangChain 中间件: HumanInTheLoopMiddleware]
   before_agent 拦截, 发现这次 tool_call 需要审批
   |
   v
[LangGraph]     调用 interrupt(hitl_request)
   -> 暂停整张图的执行
   -> checkpointer 把当前图状态存进 thread_id 对应的 checkpoint
   -> agent.invoke() 立刻返回, 结果里带 __interrupt__ 字段
   |
   v
[你的驱动代码]   从 __interrupt__ 里取出 hitl_request, 转发给审批方
   (写共享存储 / 发消息队列 / 调审批服务的 API, 具体方式自己定)
   |
   v
[审批方]        人工或另一个服务给出决定: approve 还是 reject
   |
   v
[你的驱动代码]   拿到决定, 调用
   agent.invoke(Command(resume={"decisions": [...]}), config=同一个 thread_id)
   |
   v
[LangGraph]     根据 thread_id 找到之前暂停的 checkpoint, 从中断点恢复执行
   -> interrupt(hitl_request) 这次直接返回 {"decisions": [...]}, 不再暂停
   |
   v
[LangChain 中间件: HumanInTheLoopMiddleware]
   读到 decisions, 分两种情况处理:
   approve -> 原样放行 tool_call, 真正执行 delete_logs
   reject  -> 不执行, 伪造一条 status="error" 的 ToolMessage
              content 里写 "User rejected the tool call ..."
   |
   v
[LLM]           无论哪种情况, 看到的都只是一条普通的 ToolMessage
   approve: 读到工具真实返回值
   reject:  读到 "User rejected..." 这段文字, 当成一次工具报错来处理
可以看到,暂停/恢复/checkpointer 这条线完全是 LangGraph 的活;LangChain 的中间件负责判断”这次调用需不需要拦”以及”拿到决定后怎么改写 tool_call”;DeepAgents 只是把这两层用 interrupt_on 参数包装成了一行配置。
关键机制:模型一旦决定调用被保护的工具,中间件会在工具真正执行前调用 LangGraph 的 interrupt(),
agent.invoke() 立刻返回,带上 __interrupt__ 字段。之后用 Command(resume=...) 恢复的对象,
是发给 LangGraph 图的,不是发给 LLM 的。
这里有个值得说清楚的细节:LLM 协议层面完全不知道”审批”这套机制的存在——interrupt()、Command(resume=...)、暂停/恢复、checkpointer,这些概念它一个都感知不到,批准和拒绝在消息结构上也完全一样,都只是一条 ToolMessage,没有专门的”审批结果”字段。但拒绝时那条伪造的 ToolMessage,内容里明明白白写着 “User rejected the tool call … with reason: …“——也就是说 LLM 能从文字里读到”这次是被人拒绝的”,不是一个纯粹的成功/失败布尔值。只是这段文字是以普通工具报错的形式(status="error")递给它的,跟遇到网络超时、参数错误之类的其他工具异常在结构上没有任何区别,模型不会把它当成一类特殊事件去区别对待。
真实场景下用户如何发送审批决定? 驱动 Command(resume=...) 的应该是一个等待 HTTP 请求的 API 服务:
curl -X POST http://approver-service/approve \
  -d '{"approval_id": "req_12345", "decision": "approved"}'
完整的两进程实现(一个进程跑 Agent 并阻塞等待,另一个独立进程处理审批请求)见 features/03_human_in_loop.py。
权限管理
permissions 参数接收一组 FilesystemPermission 规则,作用于内置的文件系统工具,按声明顺序匹配,
第一条命中的规则生效:
from deepagents import create_deep_agent, FilesystemPermission

agent = create_deep_agent(
    model=llm,
    permissions=[
        FilesystemPermission(operations=["write"], paths=["/etc/*"], mode="deny"),
        FilesystemPermission(operations=["write"], paths=["/tmp/repairs/*"], mode="interrupt"),
    ],
    checkpointer=InMemorySaver(),
)
mode 有三种:"allow"(默认放行)、"deny"(工具直接返回 permission denied)、"interrupt"(暂停
等待审批,效果等同于对这次文件操作单独设置了 interrupt_on)。
实测踩过的一个坑:paths 是按路径段匹配的 glob,"/etc/*" 只匹配 /etc 的直接子路径(比如
/etc/config.yml),不会匹配更深的路径(比如 /etc/app/config.yml)。写规则时得按实际目录层级设置,
不能想当然地认为一条 /etc/* 能挡住整棵子树。
完整例子(deny 和 interrupt 两种模式各跑一遍)见 features/04_permissions.py。
子 Agent 委派
subagents 参数注册的每个子 agent,都通过内置的 task 工具被主 agent 调用,委派逻辑完全由模型
自主决定,不需要在 system_prompt 里手写”遇到 X 就委派给 Y”这类规则。每个子 agent 是一个字典
(SubAgent 类型),具体有哪些可配置字段见文末「附录:SubAgent 参数」。
agent = create_deep_agent(
    model=llm,
    system_prompt="You are an incident commander investigating a production issue.",
    subagents=[
        {"name": "db-specialist", "description": "Diagnoses database connectivity problems.", "tools": [check_db_connectivity]},
        {"name": "disk-specialist", "description": "Diagnoses disk space problems.", "tools": [check_disk_usage]},
    ],
)
主 agent 只看每个子 agent 的 description 字段来决定要不要调用、调用几次、传什么任务描述。实测给
模型一句包含两个问题的事件描述(数据库连不上 + 磁盘使用率高),模型不是分两轮问的,而是在同一条
AIMessage 里一次性发起了两个 task 调用(并行委派),等两条结果都返回后再综合结论。
委派的内部过程画成图更清楚:
[主 agent 的 LLM]       看每个 subagent 的 description, 自主决定是否委派、委派几次
   task(description="...", subagent_type="db-specialist")
   task(description="...", subagent_type="disk-specialist")
   -- 可以在同一条 AIMessage 里一次发起多个 task 调用
   |
   v
[SubAgentMiddleware]    拦截每一次 task 调用, 按 subagent_type 查到对应的 SubAgent 配置
   |
   v
[构造子 agent 初始状态]
   mode="isolated"(默认): messages = [HumanMessage(description)]
                          -- 看不到主 agent 的历史, 只有这一句任务描述
   mode="fork":           messages = 主 agent 历史 + HumanMessage(description)
                          -- 接着主 agent 的对话继续说
   |
   v
[子 agent 自己的 tool-calling 循环]
   用自己的 model / system_prompt / tools 完整跑一遍 agent 循环
   可以像一个独立 agent 一样多轮调用自己的工具, 主 agent 看不到这些中间过程
   |
   v
[SubAgentMiddleware]    子 agent 产出不再调用工具的最终 AIMessage 时, 截取它的文本
   打包成一条普通的 ToolMessage, 作为这次 task 调用的返回值
   |
   v
[主 agent 的 LLM]       收到跟调用其他工具完全一样的 ToolMessage
   只看到子 agent 的最终报告文本, 看不到它内部调用了什么工具、跑了几轮
子 agent 默认是否继承主 agent 的上下文?不会。 查看 deepagents.middleware.subagents 源码,默认的
mode="isolated" 构造子 agent 初始状态时是这样写的:
subagent_state["messages"] = [HumanMessage(content=description)]
子 agent 的整个初始对话就是这一条消息,description 就是主 agent 自己写的那段文字 —— 这也是为什么
实测时模型会把 description 写得非常详细,因为这是子 agent 唯一能看到的信息。deepagents 另外提供
mode="fork",会把主 agent 的完整历史整个复制过去,让子 agent”接着主 agent 的对话往下说”,但这不是
默认行为。
完整例子见 features/06_diagnostic_workflow.py。
上下文管理
跨轮持久化靠 checkpointer,不需要自己维护消息列表:给 create_deep_agent 传一个 checkpointer,
之后每次 invoke() 时带上相同的 thread_id,图状态(包括完整对话历史)会在调用之间自动持久化。
长对话的自动摘要靠 SummarizationMiddleware:
from langchain.agents.middleware import SummarizationMiddleware
from langgraph.checkpoint.memory import InMemorySaver

agent = create_deep_agent(
    model=llm,
    middleware=[SummarizationMiddleware(model=llm, trigger=("messages", 40), keep=("messages", 20))],
    checkpointer=InMemorySaver(),
)
trigger 是触发摘要的阈值(按消息数、token 数或占比都可以),达到后会把旧消息压缩成摘要,只保留最近
keep 指定的消息量。InMemorySaver 只在进程存活期间有效,真正跨进程/跨重启持久化需要换成数据库
支持的 checkpointer,用法一致,只是构造参数不同。
完整例子见 features/05_context_management.py。
记忆
“记忆”有两条完全不同的线:一条是内置的 agents.md,另一条是需要自己接入的 LangMem。
agents.md
agents.md 不是 DeepAgents 自己发明的格式,而是一个独立的开放标准(agents.md),目的是替代过去每个 agent 工具各自的专有配置文件(.cursorrules、CLAUDE.md、.github/copilot-instructions.md 等),让同一份文件在多个 agent 工具间通用。它的消费方式不是”agent 按需查阅”,而是在会话或任务启动时被整份读入系统提示词——DeepAgents 官方对 memory 参数的说明就是 “loaded at agent startup and added into the system prompt”。如果是 monorepo,多处嵌套 agents.md 会按”离当前目录最近的一份优先”来解析。用法很简单:
agent = create_deep_agent(model=llm, memory=["/memory/AGENTS.md"])
全量注入系统提示词,agent 通过 edit_file 工具自己更新,没有检索也没有整理机制。
LangMem
LangMem 不是 DeepAgents 的一部分,是 LangChain 生态里独立的长期记忆库。它跟 DeepAgents 的结合点很直接:LangMem 提供的记忆工具(create_manage_memory_tool、create_search_memory_tool)本质上就是绑定在 LangGraph BaseStore 上的两个普通 LangChain 工具,而 create_deep_agent 本身就接受一个 store 参数,会原样透传给底层的 LangGraph runtime。接入方式就是:造一个 store,把 LangMem 的两个工具绑在这个 store 上,一起传给 create_deep_agent:
这里”两个工具”指的是 create_manage_memory_tool 和 create_search_memory_tool 这两个各自独立的函数调用,不是说其中一个函数会返回一批工具。实测确认过:create_manage_memory_tool(...) 的返回值就是一个普通的 LangChain Tool 对象(具体类型是 _ToolWithRequired),create/update/delete 这三种操作是靠调用时传的 action 参数在这一个工具内部区分的,不是三个不同的工具。
from langgraph.store.memory import InMemoryStore
from langmem import create_manage_memory_tool, create_search_memory_tool
from deepagents import create_deep_agent

store = InMemoryStore(index={"dims": 1536, "embed": "openai:text-embedding-3-small"})
namespace = ("memories", "user-1")

agent = create_deep_agent(
    model=llm,
    tools=[
        create_manage_memory_tool(namespace=namespace, store=store),
        create_search_memory_tool(namespace=namespace, store=store),
    ],
    store=store,
)
index 这个参数不是可选的装饰,是真正做语义检索的前提,实测验证过两个坑:
- 不配 index 就没有真正的检索:
InMemoryStore()不传 index 也不会报错,但store.search()不会做任何排序——它只是把这个 namespace 下的全部记忆原样返回,每条的 score 都是 None。记忆条目少的时候看起来”检索对了”,只是因为反正全都返回了;条目一多,search_memory实际上就退化成”把所有记忆都塞给模型”,跟 agents.md 全量注入没有本质区别,只是换了个工具的壳。 - embed 用的是独立凭证,跟主模型无关:
"openai:text-embedding-3-small"这类字符串走的是 LangChain 的init_embeddings,认的是标准的OPENAI_API_KEY环境变量,不会复用本文一直在用的LLM_API_KEY。而且实测确认了:这篇博客默认用的 DeepSeek 端点根本没有 embeddings 接口(直接调用报 404)。也就是说如果主模型用的是 DeepSeek 这类不提供 embeddings 的服务,embed 必须单独配一个真正支持 embeddings 的服务(比如真实的 OpenAI,或者自己构造一个Embeddings对象指向别的兼容服务),不能沿用主模型那一套 .env 配置。
create_manage_memory_tool 只管 C/U/D,不管 R——读取(语义检索)完全是 create_search_memory_tool 的职责,两者共享同一个 store 和 namespace,但没有耦合关系。看真实源码可以发现,三种 action 对应的底层逻辑很直接:
- create:id 不能传(传了会报错),内部自动生成
id = uuid.uuid4(),调用store.put(namespace, key=str(id), value={"content": content}) - update:id 必须传,调用的是同一个
store.put(...)——跟 create 走的是完全一样的底层调用,区别只是 key 是不是已存在 - delete:id 必须传,调用
store.delete(namespace, key=str(id))
底层没有”更新”这个操作——BaseStore.put 本身就是 upsert 语义,有就覆盖,没有就新建。LangMem 不做任何 diff 或合并:模型如果想”更新”一条记忆,必须把完整的新内容重新传一遍 content,不是传增量,这也是为什么工具的 description 会明确提醒模型更新/删除时必须带 MEMORY ID、创建时不要带。
存储结构是最朴素的三元组:
- namespace: 可以用
{langgraph_user_id}这类占位符在运行时从 config 动态填充,实现按用户/按团队隔离 - key: 那个 UUID
- value: 固定是
{"content": ...}这个字典。
检索能做语义搜索,靠的是 store 本身配的 embedding index(比如 InMemoryStore(index={"embed": "openai:text-embedding-3-small", ...})),跟 manage_memory 这个工具完全没关系——它只负责写,不关心 store 底层是不是支持向量检索。
工作原理:这两个工具跟 agent 手里其他自定义工具没有任何区别——模型要不要调用、什么时候调用,完全由工具自带的 instructions 驱动模型自己判断(create_manage_memory_tool 默认指令就是”识别到用户偏好、收到明确要求记住的请求、发现已有记忆过时”时主动调用)。这跟 agents.md 的关键差异在于:agents.md 是整份文件无条件塞进每一轮系统提示词;LangMem 的 search_memory 是模型主动发起的一次语义检索,只取回相关的那几条,不会把没用到的部分也占进 token 预算。
langchain 家族 agent
langchain
LangChain 官方给出的定位是”Agent = Model + Harness”:模型负责推理决策,LangChain 提供的是这套推理循环之外所有必要的东西。核心入口是 create_agent,官方原话是”LangChain provides create_agent: a minimal, highly configurable agent harness”——可以从 model、tools、prompt、middleware 这几个维度自由组合出恰好符合需求的 agent。
适用场景(官方原话):
- 需要一个”highly customizable harness, easily tailored to your use case and data”——也就是想要高度定制、但不想操心底层执行细节的场景,绝大多数单 agent 应用(客服问答、RAG、工具调用型助手)都属于这一类
- 刚开始接触 agent 开发、或者想要更高层抽象而不是自己搭状态图:官方在 LangGraph 文档里明确写的是”If you are just getting started with agents or want a higher-level abstraction, we recommend you use LangChain’s agents”
langgraph
LangGraph 官方定位是”a low-level orchestration framework and runtime for building, managing, and deploying long-running, stateful agents”——一个更底层的编排运行时,而不是模型层面的抽象。核心能力包括:在同一张图里混合确定性代码步骤和 LLM 驱动的决策步骤(“mix deterministic, hand-coded steps with LLM-driven agentic steps in the same graph”);持久化执行,能在故障后从中断的地方恢复(“persist through failures and can run for extended periods, resuming from where they left off”);以及原生的人机协同能力,可以在任意时刻检查和修改运行状态。
适用场景(官方原话):
- 长时间运行、需要在故障后恢复的有状态任务:”long-running, stateful agents” / “persist through failures and can run for extended periods”
- 需要在同一个工作流里精细混合”确定性代码步骤”和”LLM 自主决策步骤”,而不是让模型全权决定每一步:”mix deterministic, hand-coded steps with LLM-driven agentic steps”,官方强调的是”fine-grained control”
- 需要在任意节点暂停、检查甚至修改运行状态再继续,而不只是简单的批准/拒绝:”Human-in-the-loop: Incorporate human oversight by inspecting and modifying agent state at any point”
两者的关系:LangGraph 是底层运行时,LangChain 在其上提供模型和工具层面的封装——create_agent 返回的就是一个 LangGraph 编译图。
| 功能 | LangChain create_agent | LangGraph(手动搭建) | DeepAgents |
|---|---|---|---|
| 工具调用循环 | 内置 | 内置(需要自己搭图) | 内置 |
| 文件系统权限 | 需要自己包装工具 | 需要自己包装工具 | permissions 参数内置 |
| 人机协同 | 需要自己接 interrupt() |
原生支持 interrupt() |
interrupt_on 参数内置 |
| 子任务委派 | 不支持 | 需要自己画子图 | subagents 参数内置 |
| 长会话摘要 | 需要自己接中间件 | 需要自己接中间件 | 默认已挂载 SummarizationMiddleware |
| 默认工具集 | 无 | 无 | 内置文件系统 + 执行 + 委派工具 |
三者不是互斥关系:DeepAgents 的返回值就是一个 LangGraph 编译图,interrupt_on 底层用的就是
LangChain 的 HumanInTheLoopMiddleware。选择哪个取决于你要不要这批默认能力:
- 只需要一个纯粹的工具调用循环,自己控制一切细节 →
langchain.agents.create_agent - 需要完全自定义的多节点工作流(条件分支、循环、并行) → 直接用
langgraph.graph.StateGraph - 需要权限、审批、子 agent、记忆这些开箱即用 →
deepagents.create_deep_agent
附录
SubAgent 参数
subagents 里每个子 agent 是一个字典(SubAgent 类型),可配置的字段:
| 字段 | 必填 | 说明 |
|---|---|---|
| name | 是 | 唯一标识,主 agent 调用 task 工具时用这个名字指定委派给谁 |
| description | 是 | 这个子 agent 是干什么的,主 agent 只看这个字段决定要不要委派 |
| system_prompt | 否 | 子 agent 的指令;mode="fork" 时是追加在继承的主 agent 提示词后面,不是替换 |
| mode | 否 | isolated(默认)或 fork,见「子 Agent 委派」一节 |
| tools | 否 | 不填则默认继承主 agent 的 default_tools |
| model | 否 | 不填则默认沿用主 agent 的模型,要覆盖就传 “provider:model-name” 这种字符串 |
| middleware | 否 | 子 agent 会自动先套一层默认中间件栈,这里传的是在此之上追加的自定义中间件 |
| interrupt_on | 否 | 单独给这个子 agent 配置人机协同,需要主 agent 配了 checkpointer 才能用 |
| permissions | 否 | 不填则继承主 agent 的权限规则;一旦填了,是整体替换,不是叠加 |
| skills | 否 | 这个子 agent 能加载的技能路径列表;mode="fork" 下不允许设置 |
create_deep_agent 参数
create_deep_agent 一共 17 个参数,全部是关键字参数,model 是唯一实质必填的(不传会用官方已弃用的默认模型):
| 参数 | 默认值 | 说明 |
|---|---|---|
| model | None | LLM,接受 "provider:model" 字符串(比如 "openai:gpt-5.5")或已初始化的 BaseChatModel 实例 |
| tools | None | 自定义工具,在内置工具集(文件系统 + execute + task)之上追加,不会替换 |
| system_prompt | None | 用户提供的系统提示词,会跟 harness profile 的 BASE/SUFFIX 部分拼在一起 |
| middleware | () | 追加的自定义中间件,插入在内置”基础栈”之后、”收尾栈”之前,具体顺序见下一节 |
| subagents | None | 注册子 agent,支持 SubAgent(声明式)、CompiledSubAgent(预编译)、AsyncSubAgent(远程后台)三种形式 |
| skills | None | 技能文件路径列表,通过 SkillsMiddleware 按需加载进系统提示词 |
| memory | None | AGENTS.md 文件路径列表,启动时全量加载进系统提示词 |
| permissions | None | FilesystemPermission 规则列表,作用于内置文件系统工具 |
| backend | None | 文件存储/执行后端(比如 StateBackend);要用 execute 工具需要实现 SandboxBackendProtocol 的后端 |
| interrupt_on | None | 需要人工审批的工具映射,自动挂载 HumanInTheLoopMiddleware |
| response_format | None | 结构化输出格式 |
| state_schema | None | 自定义状态 schema,必须继承 DeepAgentState 以保留内置的消息合并逻辑 |
| context_schema | None | 定义运行期只读上下文的 schema,透传给 langchain 的 create_agent |
| checkpointer | None | 持久化图状态用的 checkpointer,透传给 create_agent |
| store | None | 跨线程持久化用的 store,透传给 create_agent |
| debug | False | 是否开启调试模式,透传给 create_agent |
| name | None | agent 的名字,透传给 create_agent |
| cache | None | 用的缓存,透传给 create_agent |
DeepAgents 中间件
create_deep_agent 内部会自动组装一整套中间件栈,用户传的 middleware 参数只是插在中间的一段,完整顺序(实测跟源码文档核对过)是:
基础栈:
  SkillsMiddleware            (传了 skills 才有)
  FilesystemMiddleware        (总是有)
  SubAgentMiddleware          (subagents 里有同步子 agent 才有)
  SummarizationMiddleware     (总是有, 来自 langchain, 不是 DeepAgents 自己写的)
  PatchToolCallsMiddleware    (总是有)
  AsyncSubAgentMiddleware     (subagents 里有异步子 agent 才有)

  -- 这里插入用户自己传的 middleware --

收尾栈:
  harness profile 的 extra_middleware (如果配了)
  AnthropicPromptCachingMiddleware    (总是有, 对非 Anthropic 模型是空操作)
  MemoryMiddleware                    (传了 memory 才有)
  HumanInTheLoopMiddleware            (传了 interrupt_on 才有, 来自 langchain)
  UnsupportedContentMiddleware        (总是有)
其中 SummarizationMiddleware、HumanInTheLoopMiddleware、AnthropicPromptCachingMiddleware 是 LangChain 自己的中间件,DeepAgents 只是按条件自动挂载;下面这些是 DeepAgents 自己实现的(deepagents.middleware 下):
| 中间件 | 何时挂载 | 功能 |
|---|---|---|
| FilesystemMiddleware | 总是挂载 | 提供 ls/read_file/write_file/edit_file/glob/grep 内置文件工具,并在工具层面应用 permissions 规则 |
| SubAgentMiddleware | subagents 里有同步 SubAgent/CompiledSubAgent |
注入 task 工具,处理子 agent 委派、isolated/fork 上下文构造 |
| AsyncSubAgentMiddleware | subagents 里有 AsyncSubAgent |
注入启动/查询/更新/取消/列出远程后台任务的工具;子 agent 跑在远程 Agent Protocol 服务器上,不阻塞主 agent |
| SkillsMiddleware | 传了 skills | 从 backend 加载技能文件,用”渐进式披露”(先给 metadata,按需再要全文)注入系统提示词;默认每个 thread 只加载一次 |
| MemoryMiddleware | 传了 memory | 加载 AGENTS.md 全文,启动时整份注入系统提示词 |
| PatchToolCallsMiddleware | 总是挂载 | 修补消息历史里”悬空”的 tool call(比如被摘要截断、缺了对应 ToolMessage 的那种),避免模型看到不完整的调用记录 |
| UnsupportedContentMiddleware | 总是挂载 | 把模型不支持的多模态内容块(比如发给纯文本模型的图片)替换成文字提示,避免线程后续请求全部失败 |
| RubricMiddleware | 需要在 invoke 的 state 里传 rubric 才激活(beta) | 驱动”自评估-按评分标准迭代”的循环;不传 rubric 就完全空转,可以放心常驻在栈里 |
| SummarizationToolMiddleware | 需要自己手动加进 middleware 参数 | 提供一个 compact_conversation 工具,让模型自己决定何时手动压缩上下文;复用 SummarizationMiddleware 的摘要引擎,但不会自动触发 |
